Qu’est-ce qu’une URL ? Définition, structure et exemples expliqués simplement
Une URL est l’adresse qui permet à un navigateur, une application ou un moteur de recherche de trouver une ressource précise : page web, image, vidéo, fichier, formulaire ou point d’accès d’une API. Le sigle signifie Uniform Resource Locator, que l’on traduit par « localisateur uniforme de ressource ». Dans https://critiqueplus.com/quest-ce-quune-url-uniform-resource-locator/, https indique comment communiquer, critiqueplus.com désigne le site et la partie qui suit indique la page demandée.
Une URL ne se résume donc pas à un nom de domaine. Elle peut contenir un protocole, un sous-domaine, un domaine, un port, un chemin, des paramètres et un fragment. Certaines parties sont indispensables, d’autres facultatives. Savoir les reconnaître aide à vérifier un lien avant de cliquer, à diagnostiquer une page inaccessible et à créer des adresses compréhensibles par les internautes comme par Google.
Ce guide part d’un exemple concret, démonte chaque composant, compare URL, URI et URN, puis explique les URL absolues et relatives, l’encodage, la sécurité et le référencement. Il corrige aussi plusieurs idées reçues, notamment « www est obligatoire », « le cadenas garantit qu’un site est fiable » ou « tout ce qui suit le point d’interrogation est inutile ».
Une URL, c’est quoi exactement ?
Une URL est une chaîne de caractères structurée qui indique où se trouve une ressource et, généralement, quel mécanisme employer pour y accéder. Mozilla la présente comme l’adresse d’une ressource unique sur Internet. Le standard vivant WHATWG précise les règles que les navigateurs appliquent pour analyser, normaliser et sérialiser ces adresses.
Le mot « ressource » est volontairement large. Une URL peut viser une page HTML, une feuille de style, une image WebP, un document PDF, une vidéo, un fichier téléchargeable ou une réponse d’API. Une page web charge elle-même plusieurs URL : celle du document principal, puis celles de ses polices, images, scripts et feuilles CSS.
Prenons https://www.exemple.com/guides/url?lang=fr#structure. L’adresse fournit au navigateur suffisamment d’informations pour demander une ressource au site www.exemple.com, suivre le chemin /guides/url, transmettre le paramètre lang=fr, puis afficher la partie repérée par structure.
Une URL n’est toutefois pas une promesse de disponibilité permanente. La ressource peut avoir été supprimée, déplacée ou protégée. La même ressource peut aussi être accessible par plusieurs adresses, ce qui pose un problème de duplication que les redirections et les URL canoniques permettent de gérer.
| Question | Réponse courte |
|---|---|
| Que signifie URL ? | Uniform Resource Locator |
| À quoi sert-elle ? | À localiser et demander une ressource |
| Où la voit-on ? | Dans la barre d’adresse, les liens et le code |
| Une URL est-elle toujours une page ? | Non : image, fichier, vidéo ou API sont possibles |
Quelle est la structure complète d’une URL ?
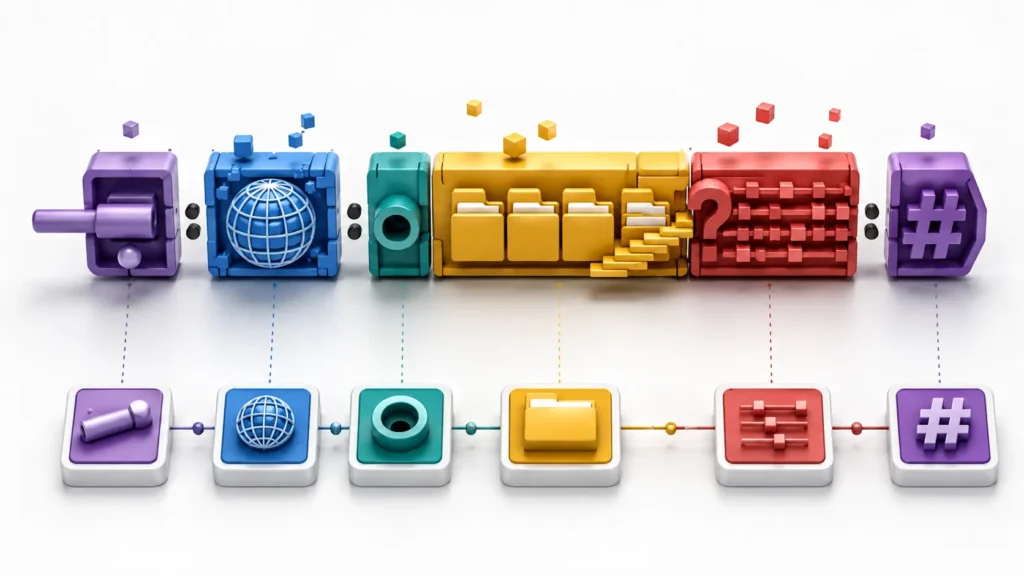
La forme générale d’une URL peut s’écrire ainsi : schéma://utilisateur@hôte:port/chemin?requête#fragment. Cette représentation pédagogique réunit toutes les parties possibles, mais une adresse ordinaire n’utilise pas forcément chacune d’elles.
Dans https://boutique.exemple.com:443/telephones/modeles?couleur=noir&tri=prix#avis,
- le schéma est https,
- l’hôte boutique.exemple.com,
- le port explicite 443,
- le chemin /telephones/modeles,
- la requête couleur=noir&tri=prix et le fragment avis.
Le séparateur :// suit généralement le schéma dans une URL hiérarchique ; le point d’interrogation ouvre la requête et le dièse introduit le fragment.
| Composant | Exemple | Fonction |
|---|---|---|
| Schéma | https | Indique le type d’accès |
| Hôte | boutique.exemple.com | Désigne le serveur logique |
| Port | 443 | Précise le service réseau |
| Chemin | /telephones/modeles | Désigne la ressource dans le site |
| Requête | ?couleur=noir&tri=prix | Transmet des paramètres |
| Fragment | #avis | Vise une partie du document |
L’ancienne syntaxe autorise aussi des informations utilisateur avant l’hôte. Elles sont déconseillées dans les URL web modernes : elles peuvent être masquées dans certaines interfaces, divulguer des identifiants et faciliter les liens trompeurs. Un mot de passe ne doit jamais être placé dans une URL, car l’adresse peut finir dans l’historique, les journaux serveur, les outils d’analyse ou un en-tête de provenance.
À quoi servent le protocole, le domaine et le port ?
Le schéma placé au début indique à l’application comment interpréter l’adresse. http et https concernent le Web, mailto prépare un courrier électronique, tel peut lancer un appel sur mobile et ftp désigne historiquement un transfert de fichiers. Le schéma n’est donc pas toujours un protocole réseau au sens strict, mais il définit le type d’URL et son traitement.
Pour une page web, HTTPS est la norme attendue. Il chiffre les échanges et authentifie le serveur à l’aide d’un certificat. Cela empêche notamment un intermédiaire de lire ou de modifier facilement la communication. Le cadenas ne garantit cependant ni l’honnêteté du propriétaire ni la qualité du contenu : un site frauduleux peut lui aussi obtenir un certificat valide.
L’hôte comprend le nom de domaine et, éventuellement, un sous-domaine. Dans blog.exemple.com, com est le domaine de premier niveau, exemple le domaine enregistré et blog le sous-domaine. www n’est qu’un sous-domaine conventionnel ; il n’est pas obligatoire.
Le port précise le service à contacter sur la machine. Les navigateurs omettent généralement :80 pour HTTP et :443 pour HTTPS, car ce sont leurs ports par défaut. Un port non standard, comme :8080, doit être indiqué. Pour comprendre pourquoi un domaine aboutit à une adresse réseau, consultez aussi notre guide sur le fonctionnement des URI et le diagnostic des erreurs DNS.
Comment lire le chemin, les paramètres et le fragment ?
Le chemin commence après l’hôte et organise la ressource dans une hiérarchie logique. Dans /guides/seo/url, chaque barre oblique sépare un segment. Cette structure ressemble à des dossiers, mais elle ne révèle pas nécessairement l’organisation physique du serveur : un CMS peut générer la page dynamiquement sans fichier url stocké dans un dossier seo.
La requête commence par ?. Elle contient souvent des paires clé-valeur séparées par &, par exemple ?page=2&tri=date. Ces paramètres peuvent filtrer un catalogue, conserver une campagne publicitaire, paginer des résultats ou transmettre une recherche. L’ordre des paramètres peut être significatif pour l’application, même lorsque deux variantes affichent le même contenu.
Le fragment commence par # et désigne une partie du document, comme #faq. Pour une page HTML classique, il est interprété par le navigateur et n’est pas envoyé au serveur dans la requête HTTP. Il permet d’atteindre un titre portant l’identifiant correspondant. Certaines applications web l’emploient aussi pour leur navigation interne.
Une confusion courante consiste à supprimer systématiquement tout ce qui suit ? ou #. Enlever un paramètre de suivi peut conserver la page, mais retirer un paramètre fonctionnel peut changer le résultat. Supprimer un fragment ramène généralement en haut de la même page. Il faut donc identifier le rôle du composant avant de modifier l’adresse.
Quelle différence entre URL, URI et URN ?
URI signifie Uniform Resource Identifier. C’est la notion générale : une chaîne normalisée qui identifie une ressource. Une URL est un type d’URI qui fournit un moyen de la localiser ou d’y accéder. Une URN, Uniform Resource Name, identifie une ressource par un nom dans un espace de noms, sans dépendre directement de son emplacement.
L’exemple classique d’URN est urn:isbn:978…, qui identifie une édition de livre par son ISBN. Une URL comme https://exemple.com/livres/978… indique en revanche un emplacement accessible. L’URN peut rester identique même si le site qui présente le livre change.
| Terme | Rôle principal | Exemple simplifié |
|---|---|---|
| URI | Identifie une ressource | Catégorie générale |
| URL | Identifie par un emplacement ou un accès | https://exemple.com/page |
| URN | Identifie par un nom persistant | urn:isbn:… |
Dans la pratique quotidienne du Web, « URL » reste le mot le plus clair pour parler d’une adresse saisie dans un navigateur. Les spécifications modernes ont fait évoluer certaines distinctions historiques ; le point important pour le lecteur est qu’une URL appartient à la famille des identifiants de ressource. Notre article consacré à la définition d’un URI approfondit cette terminologie.
URL absolue ou URL relative : laquelle utiliser ?
Une URL absolue contient les informations nécessaires pour être interprétée indépendamment du document courant : https://exemple.com/images/logo.webp. Une référence relative dépend d’une URL de base.
Dans une page située à https://exemple.com/guides/index.html, images/schema.webp peut être résolu comme https://exemple.com/guides/images/schema.webp.
Les formes relatives ne produisent pas toutes le même résultat. /images/logo.webp part de la racine du site ; images/logo.webp part du répertoire courant ; ../images/logo.webp remonte d’un niveau ; #faq vise un fragment du document actuel ; ?page=2 remplace ou définit sa requête.
| Référence | Interprétation |
|---|---|
| https://exemple.com/a | URL absolue |
| /a | Chemin relatif à la racine |
| a | Chemin relatif au dossier courant |
| ../a | Chemin après remontée d’un niveau |
| //cdn.exemple.com/a | Référence liée au schéma courant, à éviter dans le contenu moderne |
Les URL relatives facilitent le déplacement d’un ensemble de fichiers au sein d’un même site. Les URL absolues sont plus explicites dans les flux, les courriels, les données structurées et les balises canoniques. Pour le maillage interne HTML ordinaire, les deux peuvent fonctionner si elles sont correctement résolues ; l’essentiel est d’éviter les liens cassés et les bases ambiguës.
Pourquoi certains caractères sont-ils encodés dans une URL ?
Une URL est transportée sous une forme normalisée. Les lettres ASCII, les chiffres et certains caractères dits non réservés peuvent apparaître directement. D’autres caractères ont un rôle syntaxique, comme ?, &, #, / ou :. Lorsqu’un caractère doit être traité comme une donnée plutôt que comme un séparateur, il peut être encodé en pourcentage.
Ainsi, un espace est fréquemment représenté par %20. Le caractère é, encodé en UTF-8, devient une suite d’octets exprimés en hexadécimal, comme %C3%A9. Dans les requêtes de formulaire au format application/x-www-form-urlencoded, le signe + peut représenter un espace ; il ne faut pas généraliser cette règle à toutes les parties de l’URL.
L’encodage doit être effectué par composant et une seule fois. Un double encodage transforme par exemple %20 en %2520, car %25 représente le signe %. Le serveur ne retrouve alors plus la valeur attendue. Les bibliothèques standard du langage ou l’API URL du navigateur sont préférables à une concaténation manuelle.
Google recommande d’utiliser l’encodage en pourcentage lorsque nécessaire et UTF-8 pour les URL internationalisées. Un navigateur peut afficher une adresse lisible avec des caractères accentués tout en envoyant une forme encodée. Ces deux apparences ne désignent donc pas obligatoirement deux URL différentes.
Quels sont les principaux types d’URL ?
Les URL peuvent être classées selon leur schéma, leur portée ou leur comportement. Une URL HTTP ou HTTPS vise une ressource web. Une URL mailto: prépare un message, une URL tel: propose un numéro à l’application d’appel et une URL file: désigne un fichier local. Les URL data: intègrent directement une petite ressource dans l’adresse ; elles demandent une prudence particulière en raison de leur longueur et de leurs implications de sécurité.
| Type | Exemple | Usage courant |
|---|---|---|
| HTTPS | https://exemple.com/page | Page ou ressource web chiffrée |
| mailto:contact@exemple.com | Ouvrir le logiciel de messagerie | |
| Téléphone | tel:+33123456789 | Lancer ou proposer un appel |
| Fichier | file:///dossier/fichier.pdf | Ressource locale |
| Donnée | data:text/plain,… | Contenu incorporé |
On parle aussi d’URL statique lorsque l’adresse reste simple et stable, et d’URL dynamique lorsque des paramètres reflètent l’état d’une application. Cette distinction ne signifie pas qu’une page à l’URL propre est physiquement statique : un CMS peut la générer à chaque requête.
De même, une URL avec paramètres n’est pas automatiquement mauvaise pour Google. Le problème apparaît surtout quand les filtres et tris créent un nombre considérable de variantes équivalentes.
Comment une URL devient-elle une page dans le navigateur ?
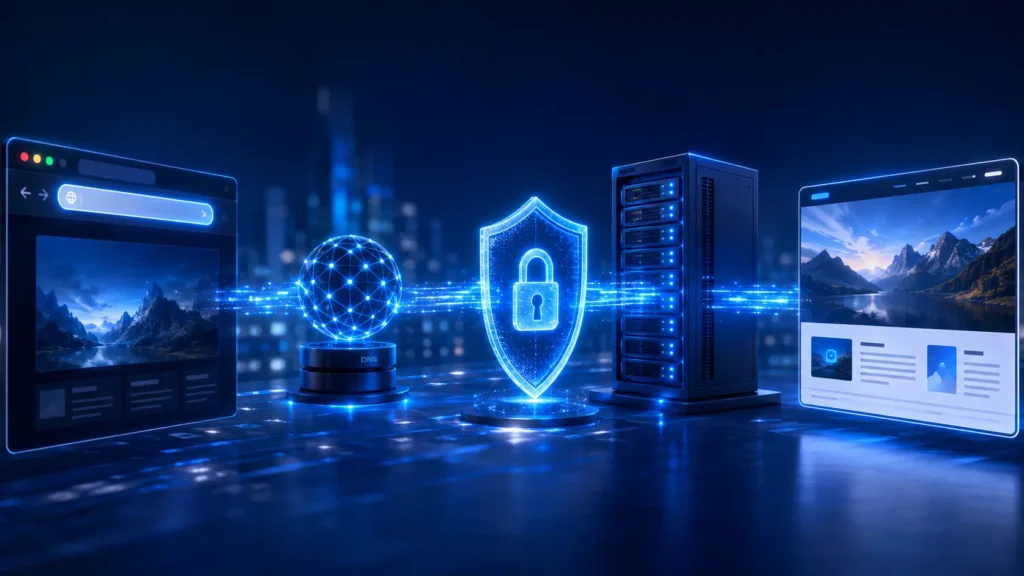
Lorsque vous validez une adresse HTTPS, le navigateur commence par l’analyser. Il identifie le schéma, l’hôte, le port, le chemin et la requête, puis normalise certains éléments. Il consulte ensuite le DNS pour convertir le nom de domaine en adresse IP, sauf si une réponse valide est déjà en cache.
Une connexion est établie vers le serveur ou l’intermédiaire approprié. Pour HTTPS, la négociation TLS permet de vérifier le certificat et de créer un canal chiffré. Le navigateur envoie ensuite une requête HTTP contenant notamment la méthode, le chemin et l’hôte. Le serveur répond avec un code d’état, des en-têtes et, le plus souvent, un contenu.
Une réponse 200 indique généralement un succès. Une redirection 301 ou 308 invite le navigateur à demander une autre URL. Un 404 signifie que la ressource demandée n’a pas été trouvée. Un 500 signale une erreur côté serveur. Une absence de réponse exploitable peut aboutir à une erreur comme ERR_EMPTY_RESPONSE, tandis qu’un refus de connexion peut déclencher ERR_CONNECTION_REFUSED.
Après réception du HTML, le navigateur l’analyse et demande les autres ressources référencées par leurs propres URL. Il construit progressivement la page visible. Une seule saisie dans la barre d’adresse peut ainsi provoquer des dizaines ou des centaines de requêtes.
Comment reconnaître une URL dangereuse ou trompeuse ?
Avant de cliquer, il faut lire l’hôte de droite à gauche autour du domaine enregistré. Dans connexion.exemple.com, le site appartient normalement à exemple.com. Dans exemple.com.site-frauduleux.net, le domaine contrôlé est site-frauduleux.net : exemple.com n’est qu’un sous-domaine destiné à tromper.
Méfiez-vous également des fautes discrètes, des caractères ressemblants provenant d’autres alphabets, des raccourcisseurs inconnus, des ports inhabituels et des adresses qui affichent des informations utilisateur avant @. Dans https://banque.example@fraude.test/, l’hôte réel est fraude.test, pas banque.example.
Le cadenas prouve surtout que la connexion avec le domaine affiché est chiffrée et que le certificat est valide pour ce domaine. Il ne certifie pas l’entreprise, l’offre ou le fichier téléchargé. Pour une opération sensible, ouvrez le site depuis un favori connu ou saisissez son domaine officiel au lieu de suivre un lien reçu.
Ne partagez pas une URL contenant un jeton de réinitialisation, un identifiant de session ou des données personnelles. Les paramètres peuvent être enregistrés dans l’historique, les captures d’écran, les journaux et les outils d’analyse. Si une alerte de certificat apparaît, notre guide sur NET::ERR_CERT_AUTHORITY_INVALID explique pourquoi il ne faut pas la contourner sans diagnostic.
Comment créer une URL optimisée pour le SEO ?
Une bonne URL SEO est stable, descriptive, courte sans être cryptique et cohérente avec l’architecture du site. Google recommande des mots compréhensibles plutôt que de longues suites d’identifiants, la langue du public et des traits d’union pour séparer les mots. exemple.com/guides/choisir-telephone est plus explicite que exemple.com/index.php?id=842&cat=17.
Le mot-clé peut figurer naturellement dans le chemin, mais il ne faut pas répéter plusieurs variantes pour « forcer » le référencement. Une adresse comme /url-definition-url-structure-url-exemple paraît artificielle et devient difficile à maintenir. Les minuscules évitent les doublons sur les serveurs sensibles à la casse. Les dates ne sont utiles que si elles font partie d’une organisation éditoriale durable.
| Bonne pratique | Exemple conseillé | Risque évité |
|---|---|---|
| Mots lisibles | /guide-url | Adresse incompréhensible |
| Traits d’union | /choisir-telephone | Segmentation ambiguë |
| Structure stable | /guides/url | Redirections répétées |
| Peu de paramètres | URL principale propre | Duplication et crawl inutile |
| HTTPS unique | Redirection vers la version choisie | Variantes concurrentes |
Les liens internes doivent utiliser des ancres descriptives et réellement aider le lecteur. Google conseille des liens HTML explorables et un texte d’ancrage concis, pertinent et compréhensible hors contexte. Le présent article relie donc les notions voisines — URI, DNS, HTTPS et erreurs de connexion — à l’endroit où elles répondent à une question, sans liste artificielle de mots-clés.
URL canonique, redirection et paramètres : que choisir ?
Plusieurs URL peuvent afficher un contenu identique : versions HTTP et HTTPS, domaine avec ou sans www, paramètres de tri, majuscules, slash final ou anciennes adresses. Cette duplication disperse les signaux et complique la mesure. Le site doit choisir une version principale et rester cohérent dans ses liens, son sitemap et ses balises.
Une redirection permanente 301 ou 308 convient lorsqu’une ancienne URL ne doit plus être utilisée et qu’une destination équivalente existe. La balise rel= »canonical » indique une préférence lorsque plusieurs variantes doivent rester accessibles. Elle constitue un signal, non une interdiction absolue. Google déconseille d’utiliser robots.txt ou l’outil de suppression d’URL pour résoudre la canonicalisation.
Les paramètres nécessaires aux filtres et au suivi ne doivent pas être supprimés aveuglément. Il faut déterminer quelles combinaisons méritent une page indexable, quelles variantes doivent pointer vers une canonique et lesquelles doivent simplement rester accessibles sans être promues dans le maillage. Les boutiques en ligne sont particulièrement exposées aux espaces d’URL quasi infinis produits par les tris, facettes et calendriers.
Après une migration, testez chaque redirection, mettez à jour les liens internes et conservez la redirection suffisamment longtemps. Une chaîne A vers B vers C ralentit l’accès et rend le diagnostic plus difficile ; redirigez si possible A directement vers C. Si le navigateur n’atteint plus la destination, commencez par distinguer la règle de redirection d’un délai de connexion au serveur.
Quelles erreurs d’URL sont les plus fréquentes ?
Une faute de frappe dans le domaine peut mener vers un autre site ou provoquer un échec DNS. Un chemin incorrect conduit généralement à une page 404. Un caractère réservé non encodé peut couper une valeur trop tôt. Un double encodage peut empêcher le serveur de reconnaître le chemin. Un paramètre manquant peut afficher un résultat différent de celui attendu.
| Symptôme | Cause probable | Vérification |
|---|---|---|
| Domaine introuvable | Faute ou DNS défaillant | Relire l’hôte et tester le domaine |
| Page 404 | Chemin supprimé ou erroné | Revenir à la rubrique parente |
| Boucle de redirection | Règles contradictoires | Tester la chaîne HTTP |
| Mauvais filtre | Paramètre absent ou modifié | Comparer la requête complète |
| Caractères étranges | Encodage incorrect | Encoder chaque composant une fois |
| Alerte HTTPS | Certificat invalide ou mauvais domaine | Vérifier le domaine et la date |
Pour un utilisateur, la bonne méthode consiste d’abord à vérifier l’adresse, retirer uniquement les paramètres manifestement facultatifs, revenir à la page d’accueil du domaine et rechercher la ressource depuis la navigation. Pour un webmaster, il faut consulter le code d’état, les journaux serveur, les redirections, la canonique et les liens qui pointent vers l’adresse fautive.
Une page inaccessible ne signifie pas toujours que l’URL est mal formée. Un serveur lent, un proxy, un VPN, un pare-feu ou un problème réseau peuvent empêcher l’accès à une adresse parfaitement valide. Le diagnostic de ERR_CONNECTION_TIMED_OUT permet de distinguer adresse, navigateur, réseau et serveur.
FAQ
Où trouver l’URL d’une page ?
Elle apparaît dans la barre d’adresse du navigateur. Sur mobile, touchez la barre ou utilisez la fonction de partage pour copier le lien complet. Vérifiez ensuite que les paramètres sensibles ne contiennent pas de données privées.
Une URL et un nom de domaine sont-ils identiques ?
Non. Le domaine n’est qu’une partie de l’URL. critiqueplus.com est un domaine ; https://critiqueplus.com/quest-ce-quune-url-uniform-resource-locator/ est l’URL complète d’une page.
WWW est-il obligatoire ?
Non. www est un sous-domaine conventionnel. Un site peut fonctionner avec, sans lui ou sur un autre sous-domaine. Le propriétaire doit choisir une version principale et rediriger l’autre pour éviter les doublons.
Une URL peut-elle contenir des accents ?
Oui. Dans le chemin et la requête, les caractères non ASCII sont généralement encodés en UTF-8 puis en pourcentage ; dans le nom de domaine, les caractères internationalisés utilisent IDNA et une représentation compatible appelée Punycode. Pour la compatibilité et la lisibilité, beaucoup de sites emploient encore des slugs sans accents.
Le fragment après le dièse est-il envoyé au serveur ?
Dans une navigation HTTP classique, non. Il sert au navigateur pour viser une partie du document. Une application JavaScript peut toutefois le lire et l’utiliser.
Faut-il supprimer les paramètres d’une URL avant de la partager ?
Seulement si vous savez qu’ils servent au suivi et ne modifient pas la ressource. Des paramètres peuvent sélectionner une langue, une page, un filtre ou un document précis. Supprimez en priorité ceux qui exposent un jeton ou une donnée personnelle, puis vérifiez que le lien fonctionne encore.
Sources officielles consultées
- WHATWG — URL Standard
- IETF — RFC 3986, Uniform Resource Identifier
- MDN Web Docs — Qu’est-ce qu’une URL ?
- MDN Web Docs — URI
- Google Search Central — Bonnes pratiques de structure des URL
- Google Search Central — Bonnes pratiques relatives aux liens
- Google Search Central — Consolider les URL en double
- IANA — Example Domains
