Qu’est-ce qu’une base de données ? Types, modélisation et langage SQL
Une base de données est un ensemble organisé d’informations enregistrées de manière à pouvoir être ajoutées, recherchées, modifiées et supprimées de façon contrôlée.
Elle permet par exemple à un site de conserver des comptes utilisateurs, à une boutique de suivre ses commandes ou à un hôpital de gérer des dossiers selon des règles strictes. La base n’est pas seulement un fichier : elle s’appuie généralement sur un système de gestion de base de données, ou SGBD, qui traite les requêtes, droits, transactions et accès concurrents.
Les bases relationnelles organisent les données en tables liées par des clés, tandis que les familles document, clé-valeur, graphe ou séries temporelles répondent à d’autres formes d’accès. La modélisation décrit les entités, leurs attributs, leurs relations et les contraintes nécessaires avant de créer les tables ou collections.
SQL est le langage standard le plus courant pour définir, interroger et modifier les données relationnelles, même si chaque moteur possède des extensions. Les transactions regroupent plusieurs opérations afin de préserver la cohérence, tandis que les contraintes empêchent certaines valeurs invalides.
Les index accélèrent des recherches ciblées, mais consomment de l’espace et ajoutent un coût aux écritures ; ils doivent être choisis à partir des requêtes réelles.
La sécurité combine authentification, autorisations minimales, chiffrement, mises à jour, journalisation et protection de l’infrastructure. Une sauvegarde utile doit être restaurable : elle doit être automatisée, surveillée, conservée séparément et testée régulièrement. Le bon choix dépend du modèle de données, des volumes, de la cohérence attendue, des compétences, du budget et des contraintes d’exploitation, pas seulement de la popularité d’un moteur.
Qu’est-ce qu’une base de données et comment fonctionne-t-elle ?
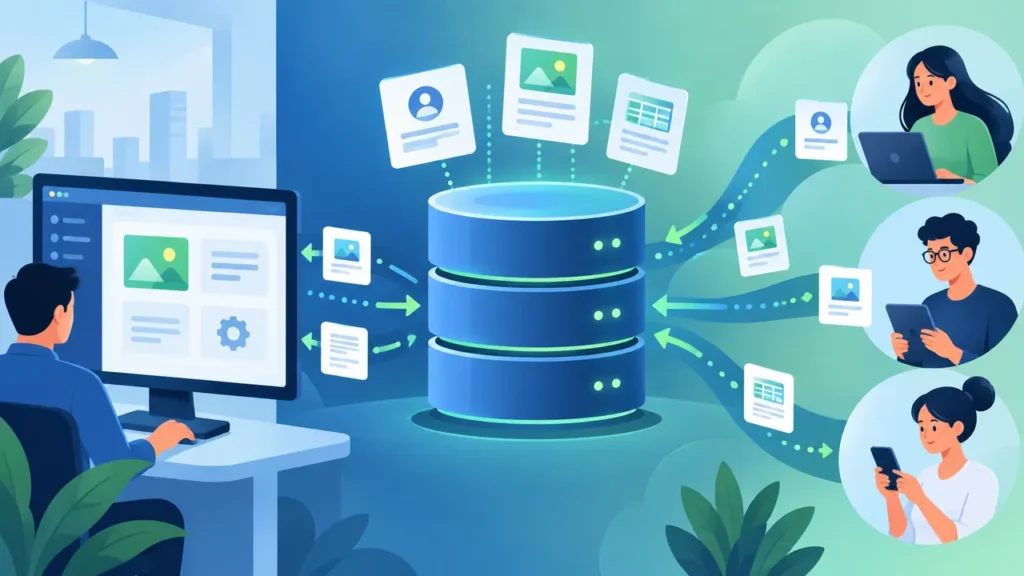
Une base de données stocke des données selon une organisation explicite. Dans une application, l’utilisateur agit sur une interface, le serveur applique les règles métier et le SGBD lit ou écrit les enregistrements. Cette séparation limite l’accès direct au stockage.
Les données possèdent un schéma plus ou moins strict : noms de champs, types, contraintes et relations. Le schéma aide à comprendre ce qui peut être enregistré. Même une base dite flexible a besoin de conventions si plusieurs services la partagent.
Le SGBD reçoit une requête, vérifie les droits, choisit une méthode d’exécution, accède au stockage puis renvoie un résultat. Il coordonne également les écritures simultanées afin d’éviter des états incohérents.
Une base peut fonctionner sur un appareil, un serveur, un cluster ou un service managé. Le lieu d’hébergement ne change pas la définition, mais modifie les responsabilités relatives aux sauvegardes, mises à jour, performances et disponibilité.
Une feuille de calcul n’est pas toujours un substitut. Elle convient à des analyses et suivis simples, tandis qu’un SGBD devient pertinent lorsque les relations, contrôles d’accès, volumes, intégrations ou écritures concurrentes exigent des garanties plus fortes.
Pour comprendre cette couche d’échange, consultez notre guide sur le fonctionnement des API utilisées entre l’interface, le serveur et la base.
Quels sont les principaux types de bases de données ?
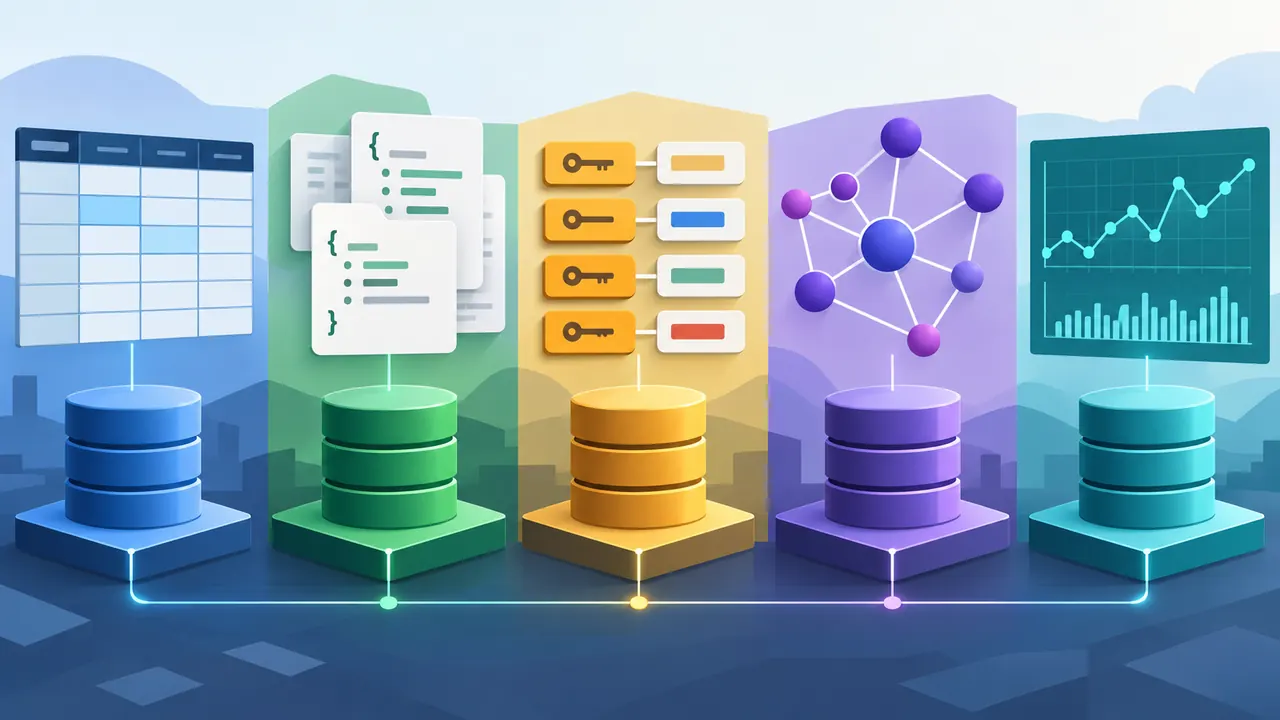
Une base relationnelle représente les données dans des tables composées de lignes et colonnes. Les clés relient les tables et SQL permet de les interroger. PostgreSQL, MySQL et SQLite appartiennent à cette grande famille, avec des architectures et capacités différentes.
Une base documentaire stocke des documents, souvent proches de structures JSON. Elle facilite les objets dont les champs évoluent, mais cette flexibilité n’élimine ni la validation ni la nécessité de prévoir les requêtes. MongoDB organise notamment les documents en collections.
Une base clé-valeur associe une clé unique à une valeur et privilégie des accès très rapides par clé. Redis est souvent utilisé pour le cache, les sessions ou certains traitements en mémoire, mais le choix dépend de la persistance et des structures nécessaires.
Une base graphe met l’accent sur les nœuds et relations. Elle convient aux parcours de réseau, dépendances ou recommandations lorsque les relations constituent le cœur de la requête. Une base de séries temporelles optimise les mesures horodatées et leur agrégation.
Les termes SQL et NoSQL décrivent des familles, pas un classement absolu. Certains moteurs ajoutent plusieurs modèles ou transactions avancées. Décrivez d’abord les données et accès critiques, puis comparez les garanties concrètes de chaque produit.
Pour un cas clé-valeur concret, consultez notre guide pour installer Redis sur un VPS.
Qu’est-ce qu’un SGBD et quel est son rôle ?
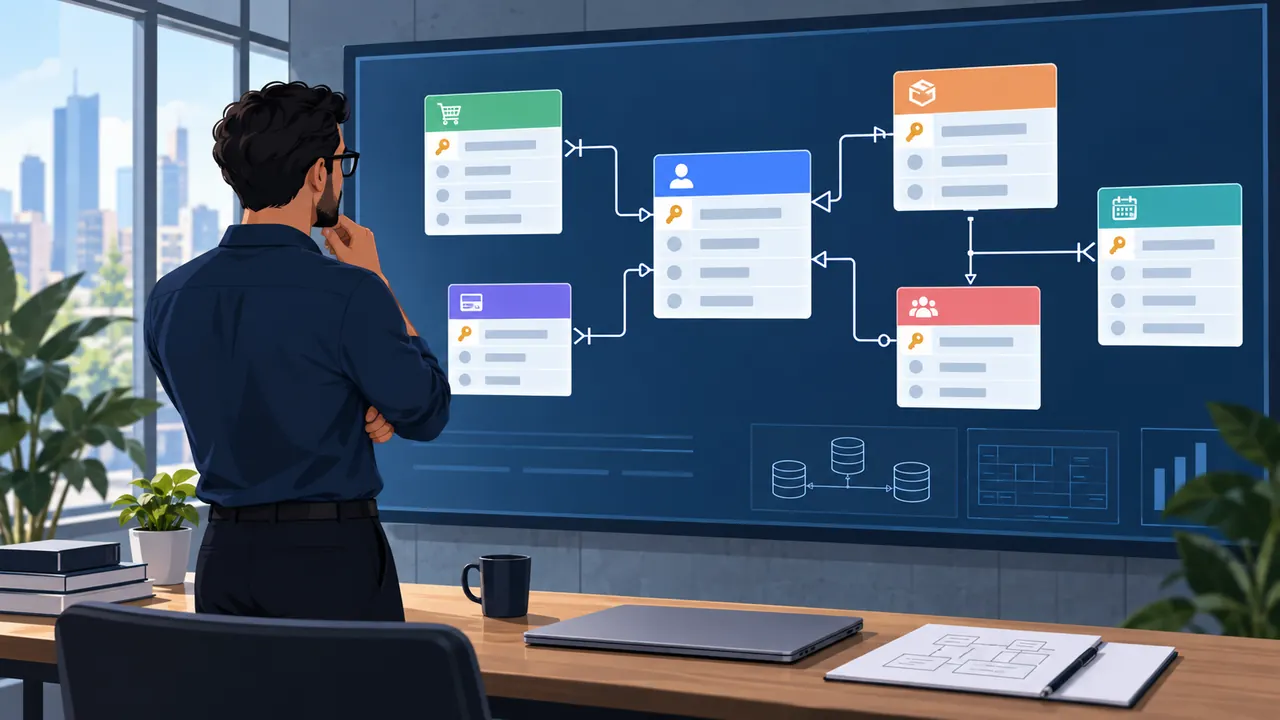
Le SGBD fournit les mécanismes qui permettent de créer les structures, valider les données, exécuter les requêtes et gérer les accès. Il conserve aussi des métadonnées sur les tables, index, utilisateurs, droits et statistiques nécessaires à l’optimisation.
Il analyse une requête et construit un plan d’exécution. Deux requêtes produisant le même résultat peuvent avoir des coûts très différents. Les statistiques, index, volumes et paramètres influencent le plan choisi par le moteur.
Le SGBD gère la concurrence lorsque plusieurs opérations lisent ou modifient les mêmes données. Les verrous, versions de lignes et niveaux d’isolation varient selon le produit. Une application doit connaître les anomalies que son niveau autorise.
Dans un service managé, le fournisseur automatise une partie de l’infrastructure, des correctifs, sauvegardes ou réplications. Le client reste responsable du modèle, des comptes, des requêtes, des données sensibles et de la vérification des restaurations selon le contrat.
Parmi les critères de comparaison figurent la licence, les formats, les extensions, les outils, l’écosystème, la haute disponibilité, les limites du service et les compétences disponibles. Le coût d’exploitation sur plusieurs années compte plus que le seul prix d’entrée.
Comment modéliser une base de données relationnelle ?
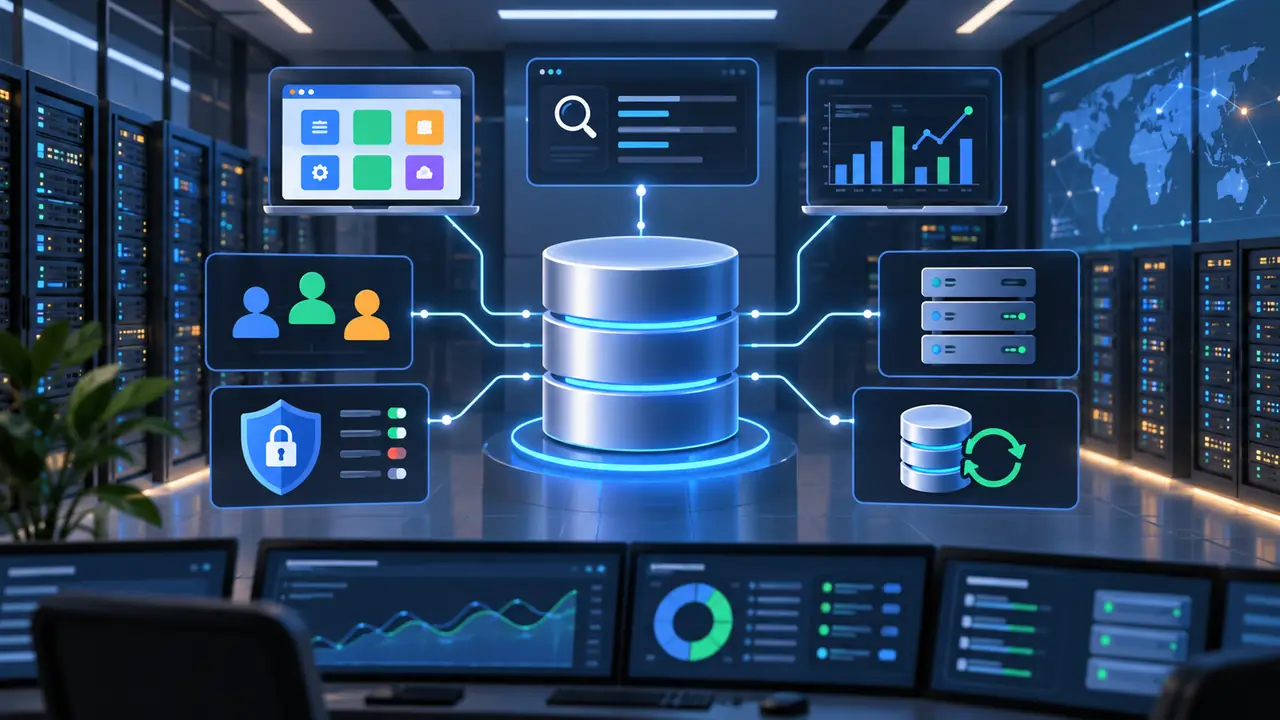
Commencez par les besoins métier. Une entité représente un objet important, comme Client, Produit ou Commande. Ses attributs décrivent l’objet. Une relation exprime par exemple qu’un client passe plusieurs commandes et qu’une commande contient plusieurs produits.
Chaque table doit disposer d’une clé primaire stable. Une clé étrangère référence la clé d’une autre table et matérialise la relation. Les contraintes d’unicité empêchent les doublons là où le métier exige une valeur unique.
La normalisation réduit les répétitions et anomalies de mise à jour en séparant les faits selon leurs dépendances. Il ne s’agit pas de multiplier les tables mécaniquement : le modèle doit rester compréhensible et soutenir les opérations attendues.
Choisissez des types précis : date pour une date, nombre pour un montant, booléen pour un état binaire. Définissez la gestion des valeurs absentes. Une chaîne vide, zéro et NULL n’ont pas la même signification.
Dessinez le modèle, nommez les relations et testez-le avec des scénarios réels : création, modification, suppression, historique et cas limites. Faites valider le vocabulaire par une personne du métier avant d’écrire les migrations.
Traitez explicitement les relations plusieurs-à-plusieurs. Une table d’association peut porter ses propres attributs, comme la quantité d’un produit dans une commande ou la date d’inscription d’un membre à un groupe. Cette information appartient à la relation et non à l’une des deux entités prises isolément.
Décidez aussi comment conserver l’historique. Écraser une adresse peut être correct pour un profil courant, mais dangereux pour une facture déjà émise. Selon le besoin, utilisez des instantanés, des dates de validité ou un journal d’événements, puis définissez clairement quelle version fait foi.
Évitez les colonnes fourre-tout dont la signification change selon une autre valeur. Elles compliquent les contraintes, les recherches et les migrations. Si des propriétés optionnelles sont réellement nombreuses, documentez leur structure et validez-les à l’entrée au lieu d’abandonner toute règle.
Comment utiliser SQL pour créer et interroger des données ?
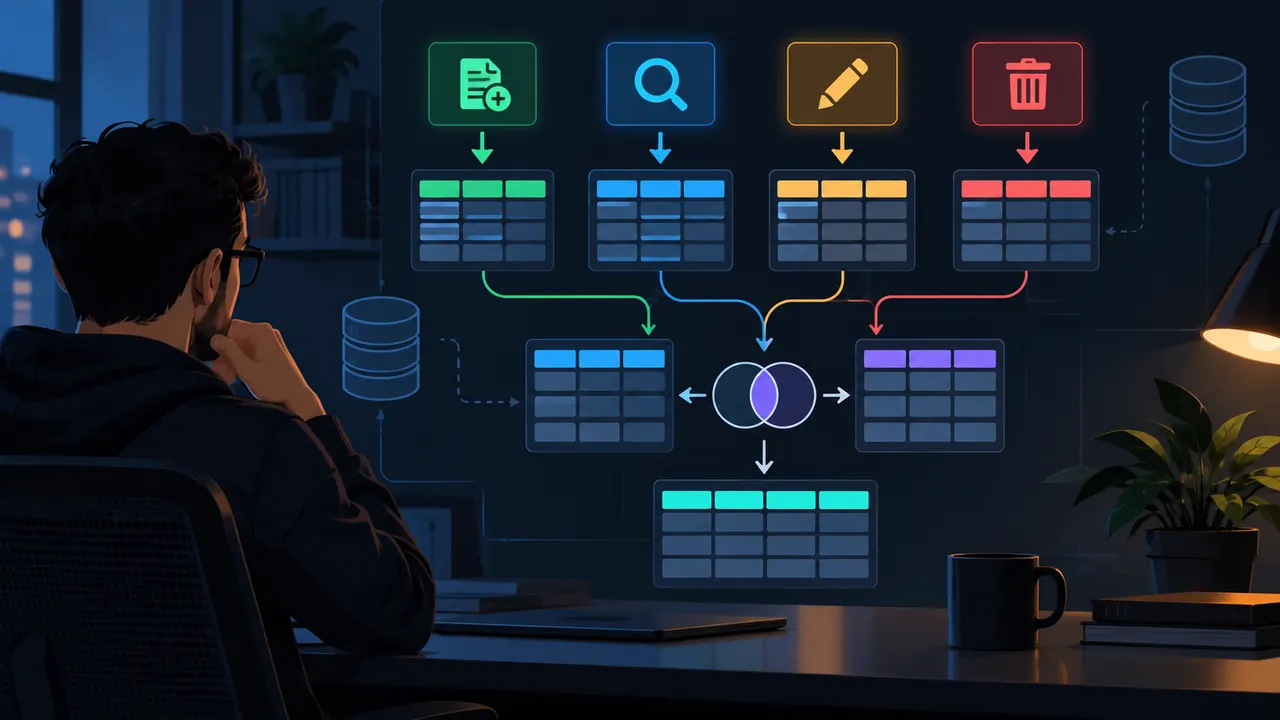
SQL comprend plusieurs familles d’instructions. CREATE définit une structure, INSERT ajoute des lignes, SELECT lit, UPDATE modifie et DELETE supprime. Les mots exacts et fonctionnalités peuvent différer ; vérifiez toujours le manuel de votre moteur.
Une requête de lecture simple sélectionne des colonnes avec SELECT, indique la table avec FROM et limite les lignes avec WHERE. Précisez les colonnes nécessaires plutôt que de demander systématiquement toutes les données.
Une jointure rapproche les lignes de plusieurs tables à partir d’une condition. INNER JOIN ne conserve que les correspondances ; LEFT JOIN conserve toutes les lignes de gauche. Une condition incorrecte peut multiplier les résultats sans produire d’erreur.
Utilisez des requêtes paramétrées dans l’application au lieu de concaténer une saisie utilisateur dans SQL. Cette règle réduit le risque d’injection et facilite souvent la gestion des types. Le compte applicatif ne doit pas posséder des droits administrateur.
Testez une modification dans un environnement adapté et examinez le nombre de lignes concernées. Pour une opération importante, préparez une transaction et une stratégie de retour arrière. Sauvegardez avant une migration qui transforme des données.
À quoi servent les transactions, contraintes et index ?
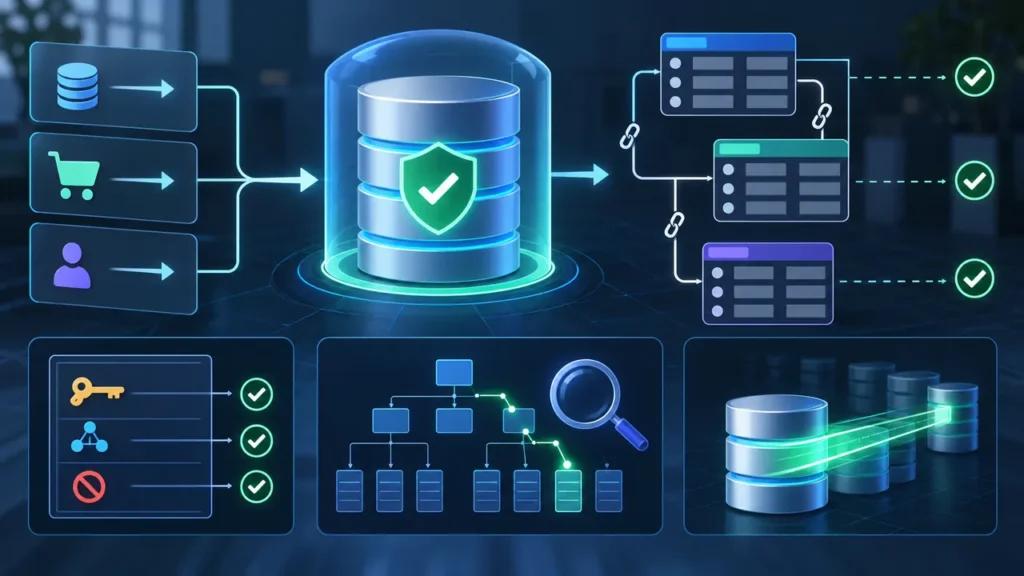
Une transaction regroupe plusieurs étapes en une opération cohérente. Dans l’exemple d’un virement, le débit et le crédit doivent réussir ensemble. En cas d’échec, un retour arrière empêche de conserver seulement une moitié de l’opération.
Les propriétés souvent résumées par ACID concernent l’atomicité, la cohérence, l’isolation et la durabilité. Leur mise en œuvre et leurs compromis dépendent du moteur, du niveau d’isolation et de la configuration ; ne vous contentez pas du sigle.
Les contraintes NOT NULL, UNIQUE, CHECK, PRIMARY KEY et FOREIGN KEY encodent des règles au plus près des données. Elles complètent les validations de l’interface et protègent contre plusieurs chemins d’écriture concurrents.
Un index fournit un chemin d’accès plus rapide à certaines lignes. Il peut porter sur une ou plusieurs colonnes ou expressions. Mais il occupe de l’espace, doit être maintenu pendant les écritures et n’accélère pas toutes les requêtes.
Mesurez avant et après avec les outils du moteur et un jeu de données représentatif. Un index rarement utilisé ou redondant peut coûter plus qu’il ne rapporte. Les performances dépendent aussi du modèle, des requêtes, de la mémoire et du stockage.
Comment sécuriser, sauvegarder et rendre une base disponible ?
Appliquez le moindre privilège : chaque personne ou service reçoit seulement les droits nécessaires. Séparez les comptes administratifs, applicatifs et de lecture. Désactivez les comptes inutilisés et protégez les secrets dans un gestionnaire adapté.
Chiffrez les connexions et, lorsque le risque le justifie, les données au repos ou certains champs. Le chiffrement ne corrige pas des autorisations excessives. Gérez les clés séparément et prévoyez leur rotation et leur récupération.
Une sauvegarde doit suivre une politique de fréquence, rétention et séparation. Combinez sauvegardes complètes et mécanismes adaptés au point de reprise attendu. Surveillez les échecs et protégez les copies contre la suppression ou le chiffrement malveillant.
Testez la restauration dans un environnement isolé et chronométrez-la. Une sauvegarde jamais restaurée reste une hypothèse. Documentez les dépendances, versions, extensions, secrets et étapes nécessaires au redémarrage de l’application.
La haute disponibilité réduit certains arrêts grâce à la réplication et au basculement, mais ne remplace pas la sauvegarde : une suppression logique peut être répliquée. Définissez séparément l’objectif de reprise des données et le délai de remise en service.
Classez les données selon leur sensibilité et leur durée de conservation. Les informations personnelles, secrets techniques et journaux ne réclament pas les mêmes accès. Une politique de suppression réduit l’exposition, à condition que ses effets sur les sauvegardes, archives et obligations légales soient documentés.
Surveillez les signaux utiles sans enregistrer inutilement le contenu sensible des requêtes. Taux d’erreur, latence, saturation des connexions, retard de réplication et croissance du stockage permettent d’anticiper de nombreuses pannes. Les alertes doivent conduire à une procédure claire et testée.
Enfin, appliquez les mises à jour du moteur selon un calendrier maîtrisé. Lisez les notes de version, testez la compatibilité des pilotes et extensions, sauvegardez, puis prévoyez un retour arrière. Retarder indéfiniment les correctifs transforme une dépendance stable en risque de sécurité et d’exploitation.
Notre dossier sur les méthodes de sauvegarde des données sur VPS complète cette stratégie.
Comment choisir la bonne base de données pour un projet ?
Listez les requêtes critiques, le volume initial, la croissance, le nombre d’écritures, la latence acceptable et les relations. Identifiez aussi les obligations de localisation, conservation, confidentialité, audit et suppression.
Choisissez relationnel par défaut lorsque les données ont des relations fortes, des règles cohérentes et des requêtes variées. Envisagez un moteur spécialisé lorsque le modèle d’accès dominant est réellement documentaire, clé-valeur, graphe ou temporel.
Évaluez la cohérence et la disponibilité attendues en situation de panne. Les systèmes distribués impliquent des compromis. Demandez ce que l’application doit faire lorsqu’un nœud, une région ou le réseau devient indisponible.
Comparez l’exploitation : sauvegardes, réplication, mises à niveau, supervision, support, compétences et coût. Un moteur techniquement puissant peut être un mauvais choix si personne ne sait diagnostiquer une panne ou restaurer les données.
Réalisez un prototype avec des données et requêtes représentatives. Mesurez la latence, la consommation et la complexité opérationnelle. Documentez la décision et ses conditions de réévaluation au lieu de choisir à partir d’un classement générique.
Vérifiez la portabilité avant de dépendre d’une extension ou d’un service propriétaire. Une fonctionnalité spécifique peut être parfaitement justifiée, mais son remplacement, l’export complet des données et le transfert des procédures d’exploitation doivent être estimés dès le départ.
Ne confondez pas montée en charge et complexité prématurée. Une instance correctement dimensionnée, un modèle propre et quelques index mesurés suffisent à de nombreux projets. La distribution sur plusieurs nœuds doit répondre à un besoin observé de capacité ou de disponibilité.
Pour départager deux solutions, construisez une grille pondérée : intégrité, latence, reprise, sécurité, facilité d’administration, disponibilité des compétences et coût total. Conservez les résultats du test, car ils rendent la décision explicable et facilitent une réévaluation lorsque les usages changent.
Si vous auto-hébergez, commencez par les critères de choix d’un serveur VPS pour débutants.
Comment créer une base de données étape par étape ?
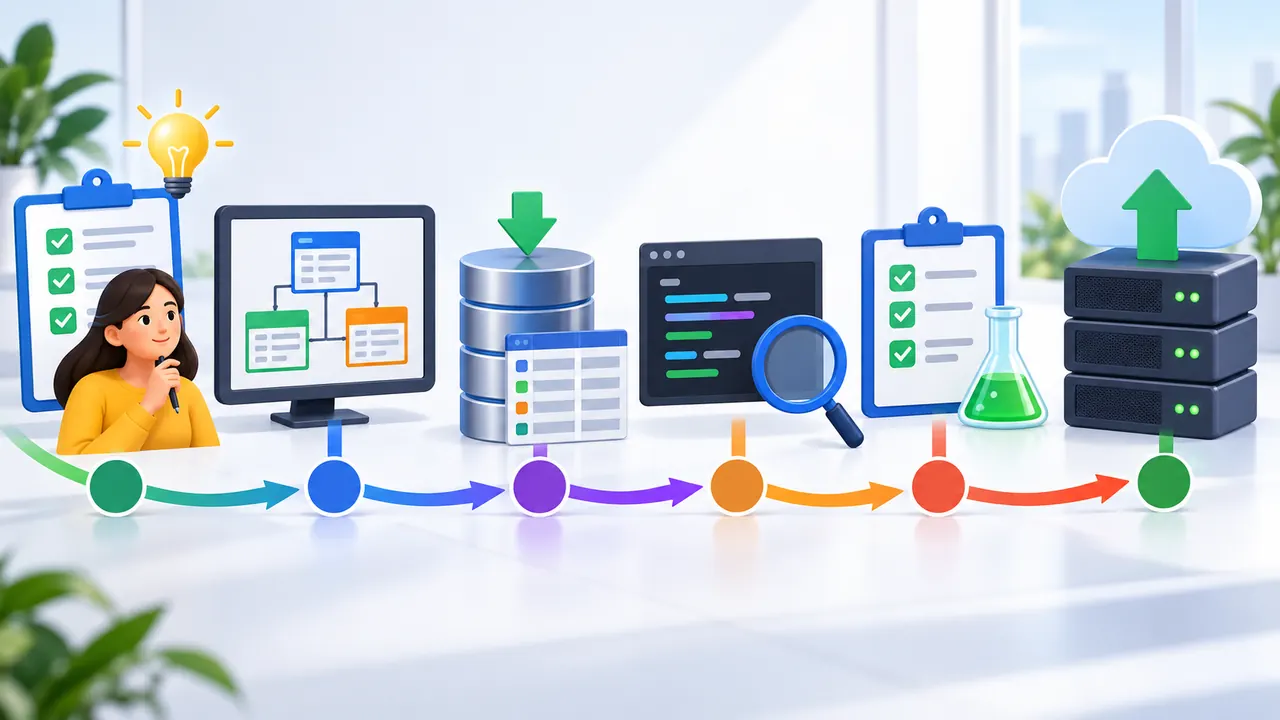
Étape 1 : formulez l’objectif, les utilisateurs et les opérations. Écrivez les données nécessaires et leur provenance. Supprimez les champs collectés sans finalité claire, surtout lorsqu’ils sont sensibles.
Étape 2 : construisez le modèle conceptuel avec entités et relations, puis le modèle logique avec tables, colonnes, clés, types et contraintes. Faites relire les règles par le métier et la sécurité.
Étape 3 : choisissez le SGBD et l’hébergement selon les critères mesurables. Préparez des environnements séparés, les comptes et la gestion des secrets. Versionnez le schéma au moyen de migrations réversibles autant que possible.
Étape 4 : créez les structures, insérez un petit jeu de données fictives et écrivez les requêtes essentielles. Testez les cas normaux, valeurs absentes, doublons, concurrence, erreurs et performances avec un volume réaliste.
Étape 5 : configurez sauvegardes, restauration, supervision, alertes, journalisation et maintenance. Déployez progressivement, vérifiez les métriques puis documentez l’exploitation. Une base est un système vivant qui doit évoluer sans perdre son intégrité.
Définissez des critères d’acceptation avant le déploiement : temps de réponse des parcours critiques, comportement après une erreur, restauration dans le délai visé et absence de droits excessifs. Un test réussi doit produire des preuves consultables, pas seulement l’absence de message d’erreur.
Planifiez les évolutions du schéma comme du code. Chaque migration doit préciser sa compatibilité avec la version précédente de l’application, sa durée probable et son comportement en cas d’interruption. Pour les grosses tables, une modification progressive limite les verrouillages et les indisponibilités.
Après la mise en service, suivez la croissance, les requêtes lentes, les erreurs, les connexions et l’espace disponible. Révisez régulièrement les comptes et les restaurations. Cette boucle d’observation transforme une installation ponctuelle en exploitation fiable et permet d’intervenir avant que l’utilisateur ne constate la panne.
Une plateforme telle que Coolify pour déployer des applications et bases de données simplifie certaines opérations sans supprimer la maintenance.
FAQ
Quelle différence entre une base de données et un SGBD ?
La base désigne les données organisées ; le SGBD est le logiciel qui les stocke, interroge, protège et coordonne.
SQL est-il une base de données ?
Non. SQL est un langage utilisé par les systèmes relationnels, avec des variantes selon les moteurs.
Quelle base choisir pour débuter ?
SQLite convient à de petits projets locaux ; PostgreSQL ou MySQL sont courants côté serveur. Le besoin réel doit guider le choix.
NoSQL signifie-t-il sans structure ?
Non. Un schéma peut être plus flexible, mais la validation et les conventions restent indispensables.
À quoi sert une clé primaire ?
Elle identifie chaque ligne de manière unique et sert souvent de cible aux relations.
Qu’est-ce qu’une clé étrangère ?
C’est une valeur qui référence une clé d’une autre table et permet de contrôler une relation.
Un index accélère-t-il toujours une base ?
Non. Il accélère certaines lectures mais ajoute de l’espace et du travail aux écritures.
Une réplication remplace-t-elle une sauvegarde ?
Non. Les erreurs et suppressions peuvent être répliquées ; une copie restaurable séparée reste nécessaire.
Comment éviter l’injection SQL ?
Utilisez des requêtes paramétrées, validez les entrées et limitez les droits du compte applicatif.
Quand utiliser une base plutôt qu’un tableur ?
Lorsque les volumes, relations, règles, accès concurrents, automatisations ou contrôles d’accès dépassent un suivi simple.
Sources officielles Consultées
- Concepts relationnels — PostgreSQL
- Langage SQL — PostgreSQL
- Transactions — PostgreSQL
- Index — PostgreSQL
- Présentation de MySQL
- Tutoriel MySQL
- Bases et collections — MongoDB
- Modélisation des données — MongoDB
- Présentation officielle de SQLite
- Sauvegarde SQLite
Conclusion
Une base de données organise des faits pour qu’ils restent interrogeables, cohérents et protégés au fil des changements. Sa qualité dépend d’abord du modèle, des contraintes et des responsabilités, puis du moteur choisi. SQL, transactions et index deviennent utiles lorsqu’ils répondent à des opérations concrètes et mesurées.
Avant la mise en production, testez les requêtes, droits, migrations, sauvegardes et restaurations. Documentez le vocabulaire, les sources et les objectifs de reprise. Commencez avec l’architecture la plus simple qui satisfait réellement les exigences, puis faites-la évoluer à partir de mesures et non d’hypothèses.
